
 前往官网


 发布
AI / BENCHMARK
AI Benchmark
本页汇总 G32S10 在 Magik 平台上的训练量化精度、后量化精度与板端模型效率,用于评估模型在目标硬件上的精度损失和推理性能。
整体框架(Overall Framework)
Magik 是面向端侧 AI 应用打造的全栈式深度神经网络开放平台,覆盖模型训练、模型优化转换和模型部署推理。平台支持接入 ModelZoo、TensorFlow、mxnet、PyTorch、Caffe 与 ONNX 等模型来源,并通过 TrainingKit、TransformKit 和 InferenceKit 完成训练量化、编译优化与目标平台部署。
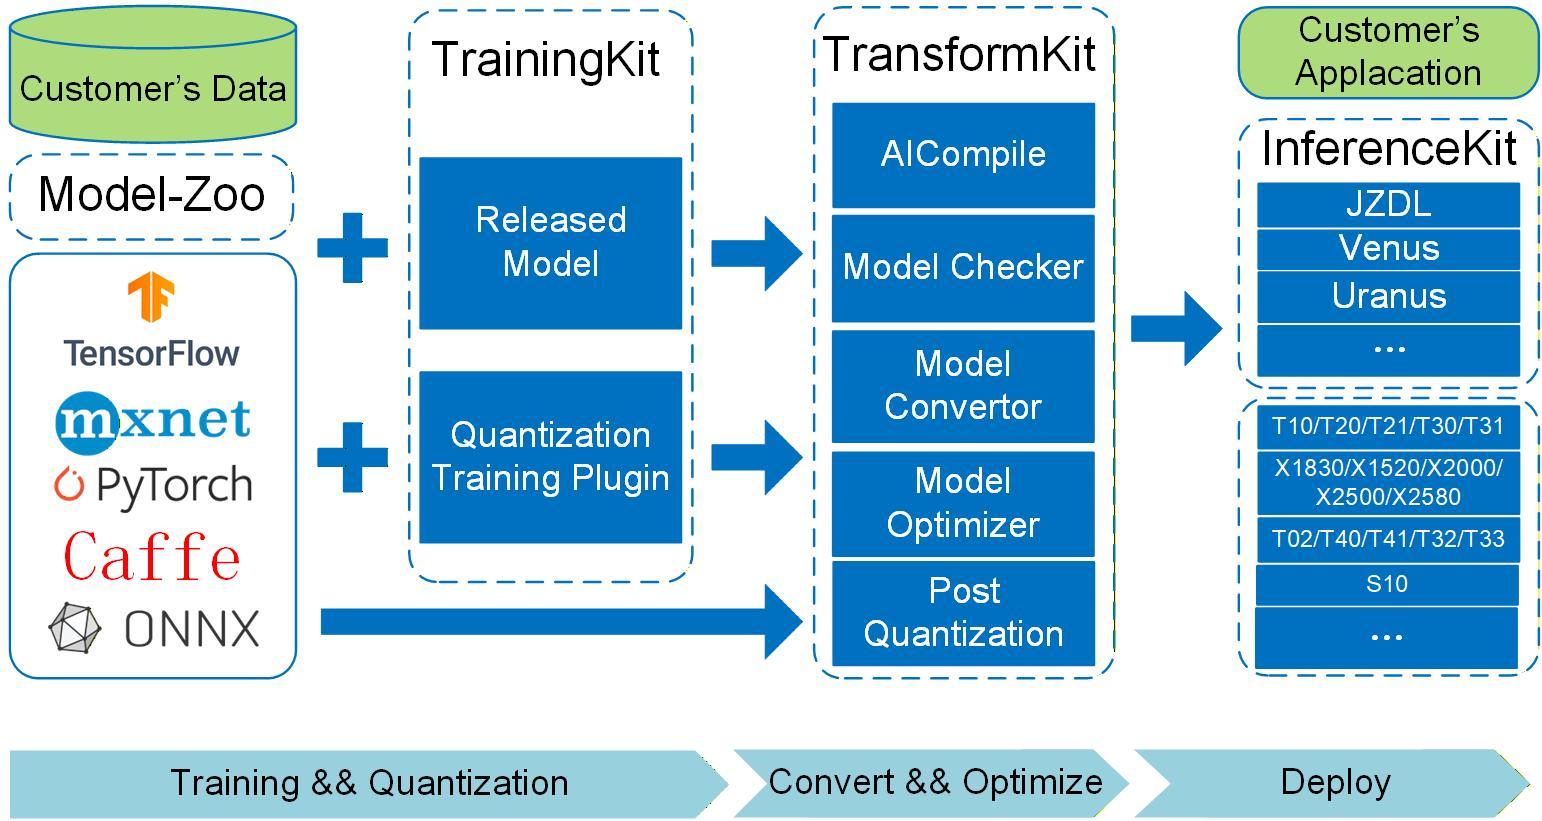
图 1. Magik AI 全栈开发流程
训练量化精度(QAT)
基于 Magik 平台进行训练量化,相关开源模型基于 ImageNet、COCO 等数据集。32bit、8bit 与 4bit 的训练量化精度如下。
表 1. 训练量化精度
| Network | 32bit | 8bit | 4bit |
|---|---|---|---|
| inceptionv3 | 77.15% | 77.09% | 76.9% |
| mobilenetv2 | 71.87% | 71.516% | 68.08% |
| resnet18 | 69.76% | 69.61% | 69.11% |
| resnet50 | 76.14% | 76.02% | 75.53% |
| densenet121 | 74.43% | 75.64% | 72.55% |
| ssd_mobilenet_v1 | 67.59% | 67.56% | 66.98% |
| retinaface | 94.51% | 94.26% | 93.42% |
| facerec | 99.23% | 99.15% | 98.26% |
| yolov5s_face | 94.64% | 94.58% | 93.34% |
| yolov5s_person | 70.1% | 70.0% | 69.6% |
| yolov5m_person | 79.2% | 79.1% | 79.0% |
后量化精度(PTQ)
基于 Magik 平台后量化至 8bit,相关开源模型基于 ImageNet、COCO 数据集。32bit 与 8bit 的后量化精度如下,最后一列为两种精度之间的差值。
表 2. 后量化精度
| Network | Framework | Resolution | DataSet | 32bit | 8bit | 差值 |
|---|---|---|---|---|---|---|
| yolov3 | onnx | 416*416 | coco | 55.30% | 55.20% | 0.10% |
| yolov5s | onnx | 640*640 | coco | 56.80% | 56.54% | 0.26% |
| yolov5m | onnx | 640*640 | coco | 64.10% | 63.78% | 0.32% |
| yolov5l | onnx | 640*640 | coco | 67.30% | 66.97% | 0.33% |
| yolov5x | onnx | 640*640 | coco | 68.90% | 66.56% | 2.34% |
| ssd_mobilenet_v1 | tf | 300*300 | coco | 35.36% | 35.25% | 0.11% |
| ssd_mobilenet_v2 | tf | 300*300 | coco | 37.13% | 36.32% | 0.81% |
| mobilenetv1 | tf | 224*224 | ImageNet | 70.95% | 70.03% | 0.92% |
| mobilenetv2 | tf | 224*224 | ImageNet | 71.72% | 70.62% | 1.10% |
| shufflenetv2 | onnx | 224*224 | ImageNet | 69.36% | 68.67% | 0.69% |
| resnet50 | onnx | 224*224 | ImageNet | 76.15% | 75.95% | 0.20% |
| vgg16 | onnx | 224*224 | ImageNet | 71.59% | 71.45% | 0.14% |
| inceptionv3 | onnx | 224*224 | ImageNet | 69.49% | 69.36% | 0.13% |
| googlenet | onnx | 224*224 | ImageNet | 69.78% | 69.77% | 0.01% |
| squeezenet | onnx | 224*224 | ImageNet | 58.10% | 57.65% | 0.45% |
| densenet121 | caffe | 224*224 | ImageNet | 74.76% | 74.17% | 0.59% |
| densenet201 | caffe | 224*224 | ImageNet | 77.16% | 74.64% | 2.52% |
| inceptionv1 | tf | 224*224 | ImageNet | 70.40% | 70.43% | 0.03% |
| inceptionv4 | tf | 299*299 | ImageNet | 79.43% | 79.28% | 0.15% |
| inceptionv1 | caffe | 224*224 | ImageNet | 72.30% | 70.53% | 1.77% |
| resnet18 | caffe | 224*224 | ImageNet | 65.91% | 65.83% | 0.08% |
| resnet50 | caffe | 224*224 | ImageNet | 75.10% | 74.38% | 0.72% |
| squeezenetv1.1 | caffe | 227*227 | ImageNet | 56.42% | 56.24% | 0.18% |
| mobilenetv1 | caffe | 224*224 | ImageNet | 70.90% | 70.00% | 0.90% |
| mobilenetv2 | caffe | 224*224 | ImageNet | 71.83% | 71.27% | 0.56% |
| squeezenetv1.0 | caffe | 227*227 | ImageNet | 55.84% | 55.36% | 0.48% |
| vgg16 | caffe | 224*224 | ImageNet | 71.01% | 70.97% | 0.04% |
模型效率(Model Efficiency)
相关开源模型在 G32S10 板端执行前向推理时的效率如下,fps 表示每秒推理帧数。
表 3. 模型效率
| Network | Resolution | GOPs | 8bit(fps) | 4bit(fps) |
|---|---|---|---|---|
| yolov5n | 384x384x3 | 1.487 | 39.00 | 55.56 |
| yolov5s | 384x384x3 | 5.92 | 14.42 | 21.20 |
| resnet18 | 224x224x3 | 3.71 | 32.42 | 57.32 |
| resnet50 | 224x224x3 | 8.26 | - | 16.76 |
| mobilenetv1 | 224x224x3 | 1.156 | 31.86 | 43.62 |
| mobilenetv2 | 224x224x3 | 0.929 | 37 | 63.64 |
数据说明
表中“-”表示当前文档未提供对应测试数据。
精度结果用于反映量化前后的模型精度变化,fps 结果用于反映指定分辨率和量化配置下的板端推理效率。
测试结果与 SDK、模型版本、输入尺寸及运行配置有关,实际性能以对应版本的实测结果为准。